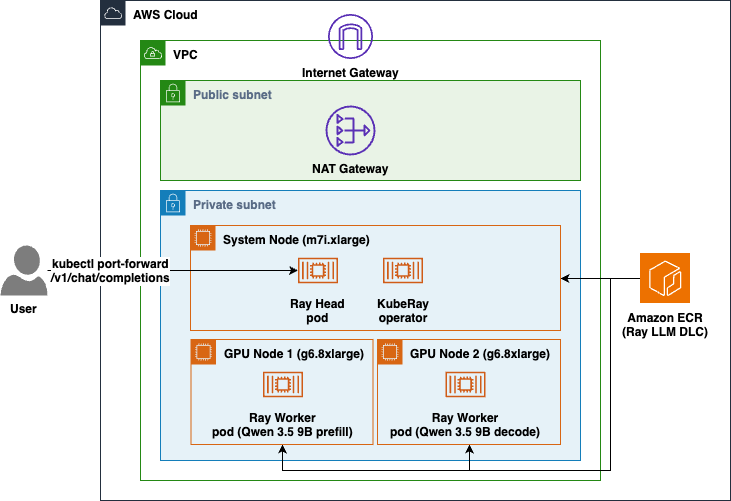
Learn how to deploy one large language model across two GPU nodes on Amazon EKS using the multi-node Ray LLM Deep Learning Containers, with separate prefill and decode nodes behind one OpenAI-compatible endpoint. The pre-built container ships the full inference stack, so you configure the deployment instead of assembling it.
Run multi-node inference workloads using Ray LLM Deep Learning Containers
Riassunto della pubblicazione. Le condizioni di AWS Machine Learning non consentono la riproduzione integrale dell'articolo: leggi il testo completo sul sito originale.
Riassunto della fonte (Inglese)
Leggi l'articolo completo
aws.amazon.com