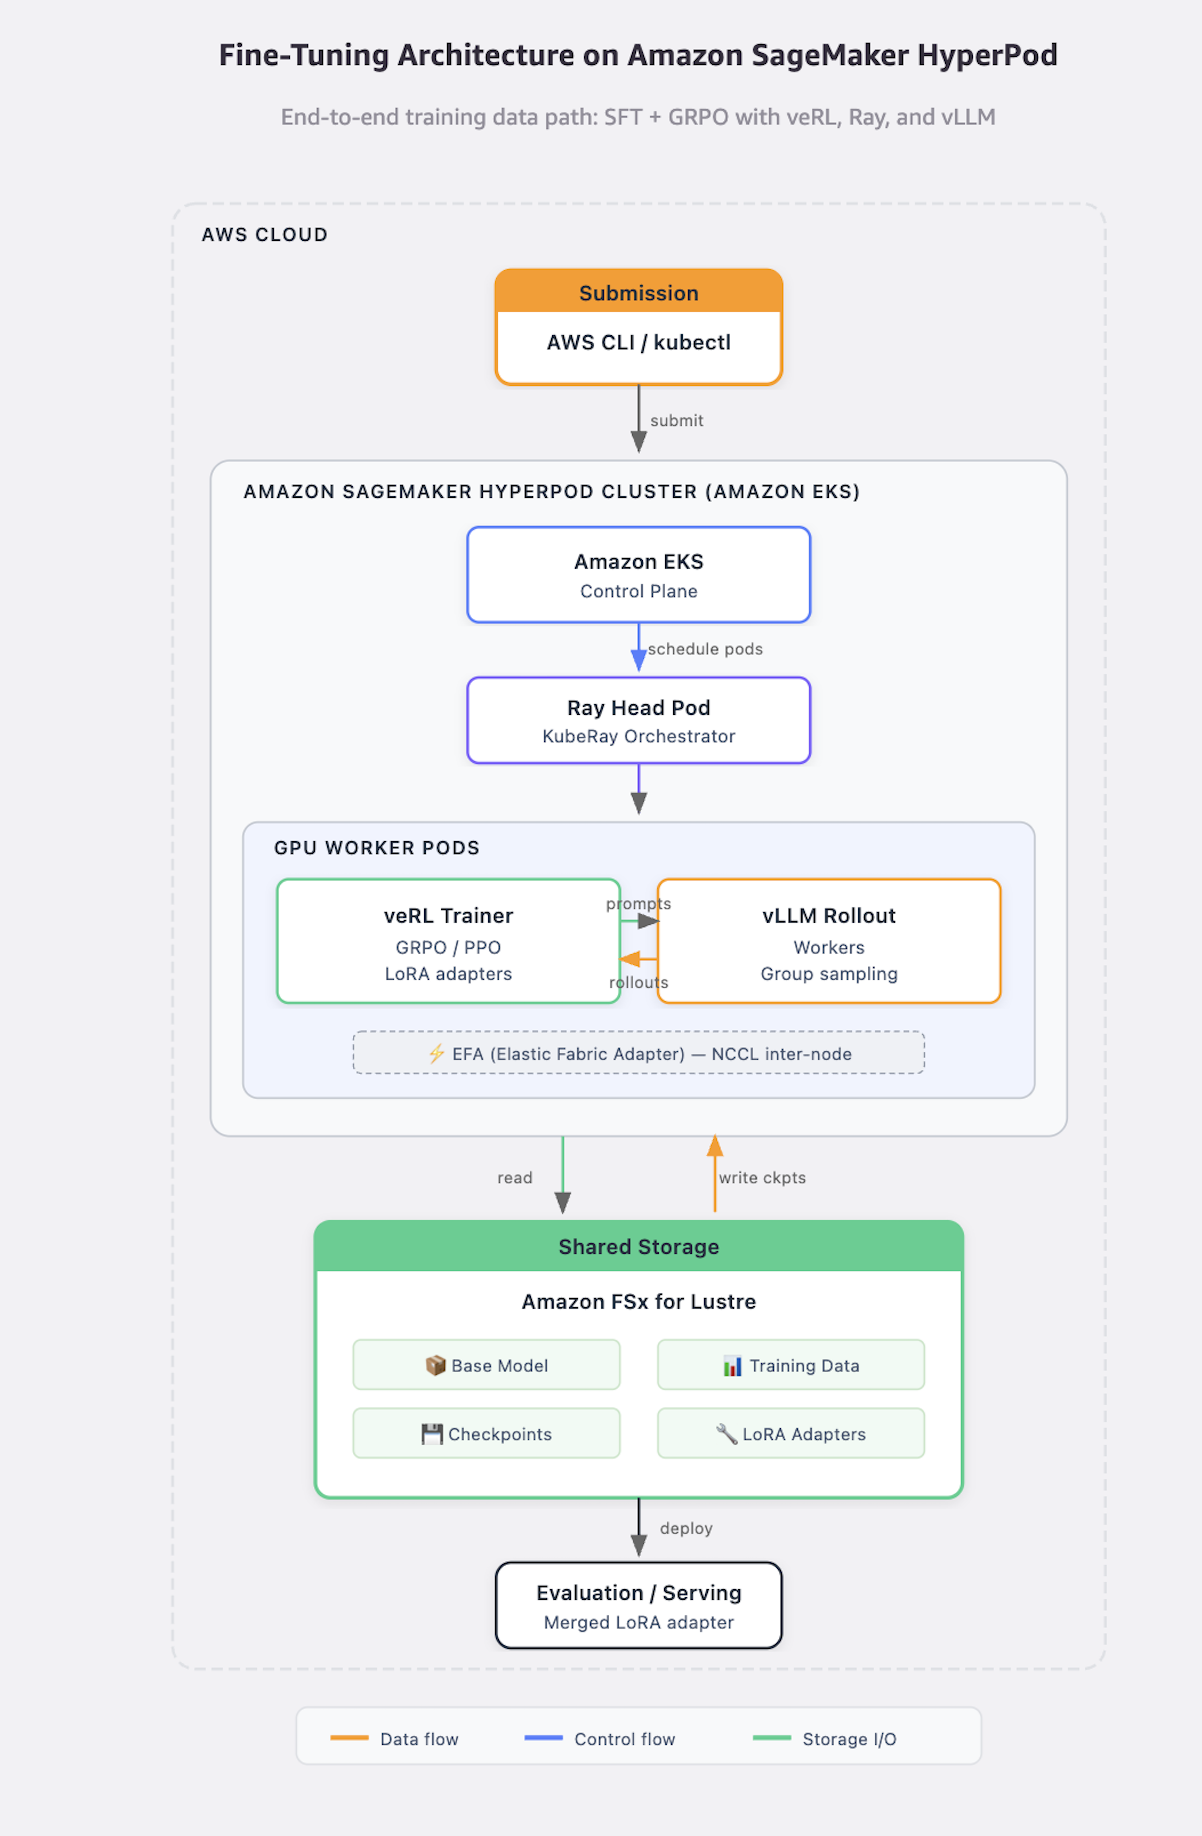
Learn how we fine-tuned GPT-OSS-20B for multilingual reasoning on Amazon SageMaker HyperPod, and how to decide between supervised fine-tuning (SFT) and reinforcement learning with GRPO. SFT took reasoning-language accuracy from 22% to 100%, and GRPO added measurable gains where headroom existed.
Fine-tuning GPT-OSS-20B for multilingual reasoning on Amazon SageMaker HyperPod
Riassunto della pubblicazione. Le condizioni di AWS Machine Learning non consentono la riproduzione integrale dell'articolo: leggi il testo completo sul sito originale.
Riassunto della fonte (Inglese)
Leggi l'articolo completo
aws.amazon.com