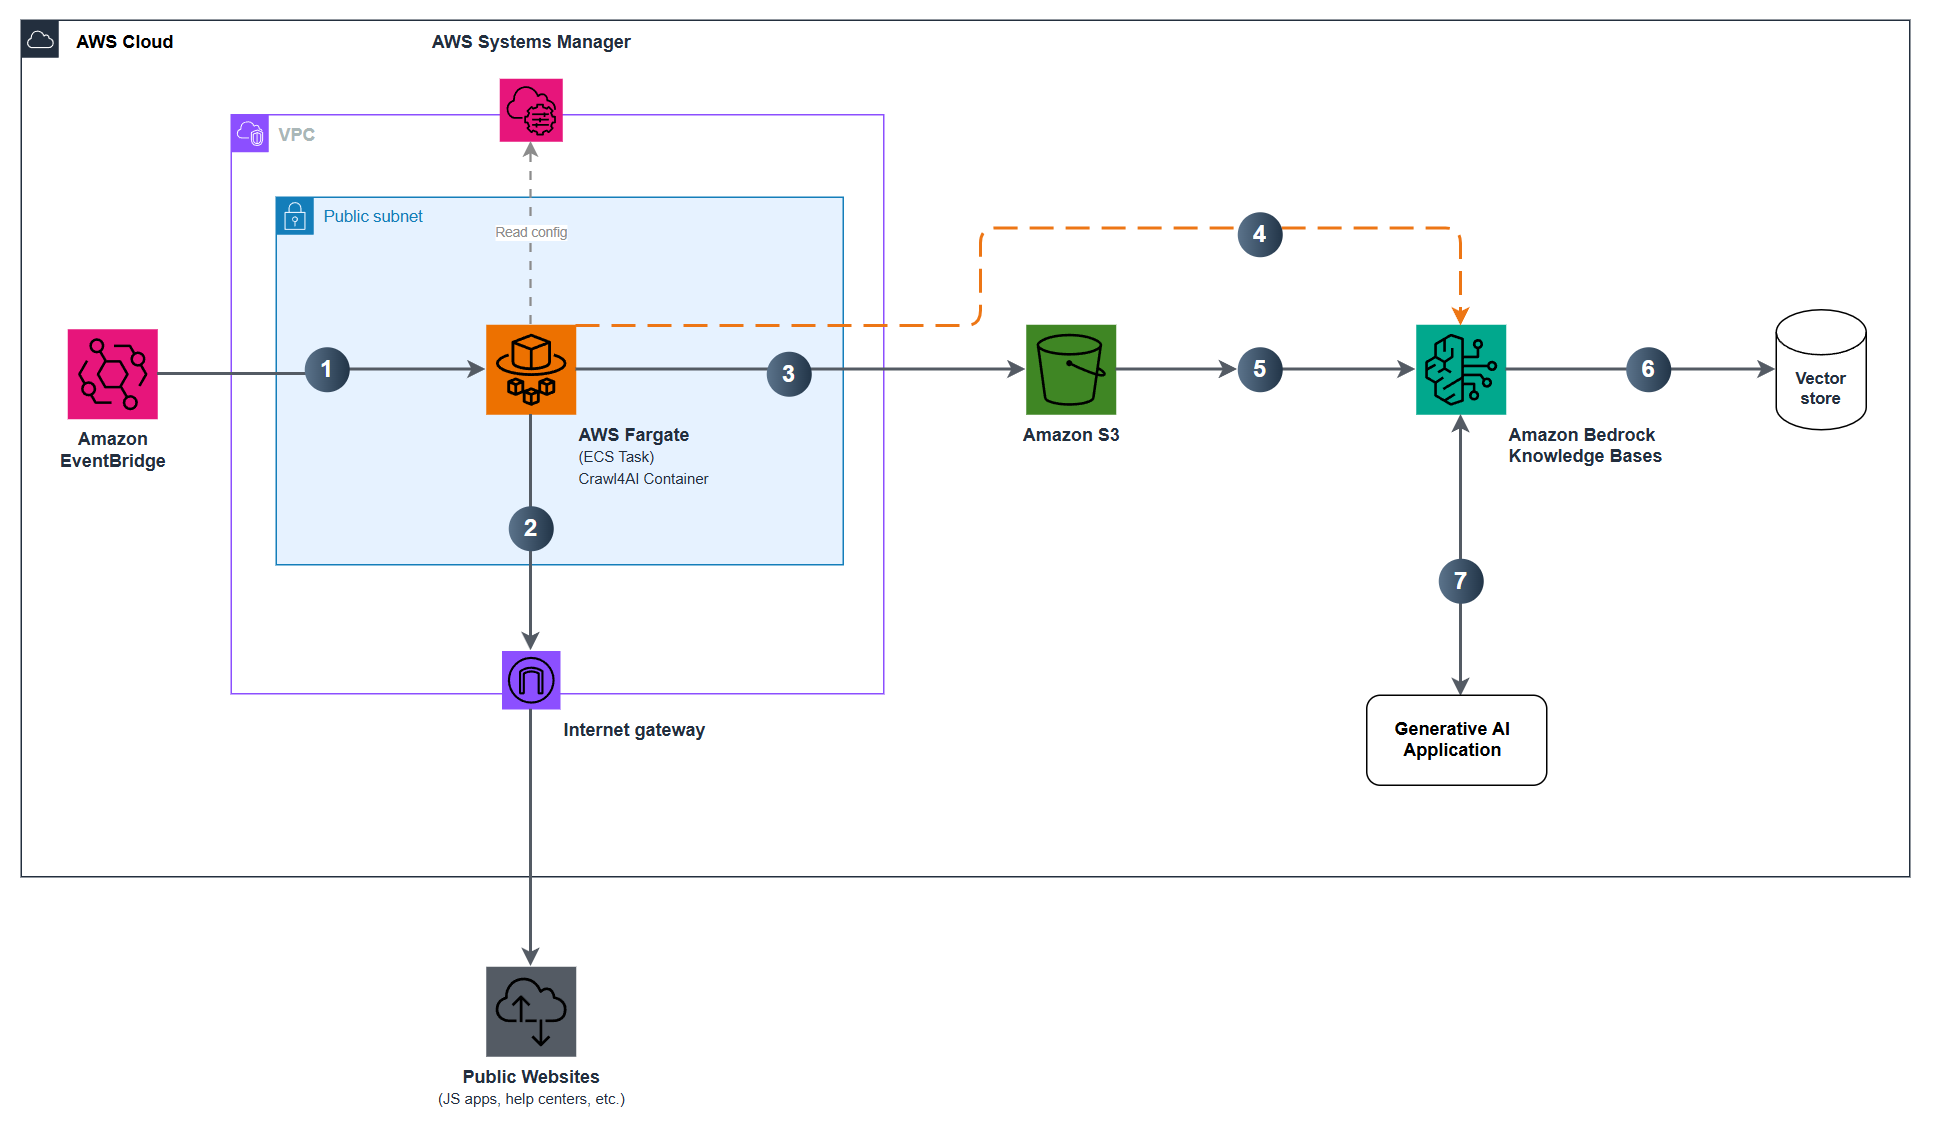
This post shows how to use Crawl4AI, an open source web crawler, as a content preparation layer for Amazon Bedrock Knowledge Bases, handling JavaScript rendering, selective extraction, and custom metadata enrichment before web content reaches an Amazon S3 data source.
Prepare web content for Amazon Bedrock Knowledge Bases with Crawl4AI
Riassunto della pubblicazione. Le condizioni di AWS Machine Learning non consentono la riproduzione integrale dell'articolo: leggi il testo completo sul sito originale.
Riassunto della fonte (Inglese)
Leggi l'articolo completo
aws.amazon.com